もはやカルト

スウェーデン王立工学アカデミーにおけるジェフリー・ヒントン教授のセミナー

[youtube動画]

(いまさら 2024/12/5 の講演動画を観たら、ストレートにチョムスキー批判していて面白かった(失礼))

7分30秒辺り

彼らがその問題をそれほど深刻に受け止めていない理由の一つは、現在存在するAIシステムが、実際には物事を「理解」しているとは考えていないからです。 チョムスキーの影響を受けた人々(その多くは言語学者です)のグループは、こうしたAIを「確率論的なオウム(stochastic parrots)」と呼んでいます。 彼らの見解では、AIとは単なる統計的な仕掛けに過ぎません。膨大なテキストデータを取り込み、それらを継ぎ合わせてそれらしく見せかけているだけであり、人間が現在行っているような意味での「理解」は、実際にはできていないと考えています。

10分30秒前後

彼らはチョムスキーから強い影響を受けている。チョムスキーは、言語は(表面的に見えるような形では)学習されるものではないと、何世代にもわたる言語学者たちに信じ込ませることに成功したのだ。 言語が学習されるものではないなどというのは、どう考えても馬鹿げている。もし、それほど明らかに馬鹿げたことを人々に信じ込ませることができるのなら、それはもうカルトだと言える。

(AIモード解説)

ヒントンは、進化という極めて遅いプロセスが、脳がもっと速く学習できるはずのものをわざわざ遺伝子にエンコードしたと主張するのは不合理である、と説明しています。

「ニューラルネットワークは、チョムスキー言語学派がこれまでに生み出したどんなものよりも、はるかに優れた言語処理を行っている」

「私は普遍文法を信じていないし、大規模言語モデルもそんなものは信じていない。LLMは、チョムスキーが『不可能だ』と言ったことをやってのけているのだ」

「なぜ統計的(確率的)であることと、意味を『理解している』ことが対立しなければならないのか」

(長年、苦しめられたんでしょうねぇ・・・)

脳内マップマッチング、脳内キャリブレーション

脳の羅針盤を見つける (2019/8/12)

本日Nature Neuroscience誌に掲載された研究論文で、MITの神経科学者たちは、マウスの脳内で、環境に関する「高次元」の複雑な情報を、脳内の単純な抽象概念へと変換する回路を特定した。

覚醒および睡眠を通じた、典型的な認知回路の固有アトラクター多様体と集団ダイナミクス

「外界には角度を示す目盛りがないため、私たちの頭の向きは脳によって抽出、計算、推定される必要があります」と、マクガバン研究所の准研究員であり、この論文の筆頭著者であるイラ・フィエテ氏は説明する。「私たちが用いた手法によって、脳内に低次元の概念、つまり抽象的な羅針盤が出現することを実証することができました。」

研究者らによると、この抽象的な羅針盤は、頭部が外部世界に対して現在向いている方向を表す一次元のリングである。

・・・

これまでのハエの脳の研究で、ハエの頭の方向の変化を表す神経細胞の楕円形の環が物理的に存在することが明らかになっており、

多様な視覚シーンにおける安定した進行方向表現の生成 (2019)

研究者たちは、そのようなシステムが哺乳類にも存在するのではないかと推測していた。

今回のマウスを用いた新たな研究で、フィエテ氏らは、マウスが自由に動き回る環境下で、空間ナビゲーションに関与すると考えられている視床前背側核(ADN)にある多数のニューロンの神経活動を数時間にわたって測定した。そして、マウスの頭の向きが変わるにつれて、ADN回路のニューロンがどのように発火するかをマッピングした。

これらのデータポイントが集まると、単純で持続的なリング状の雲が形成された。
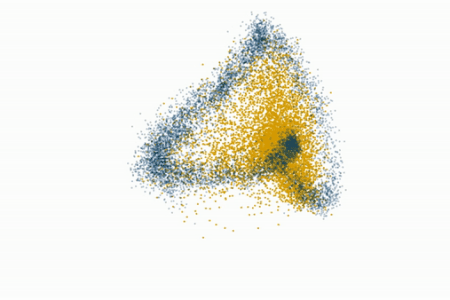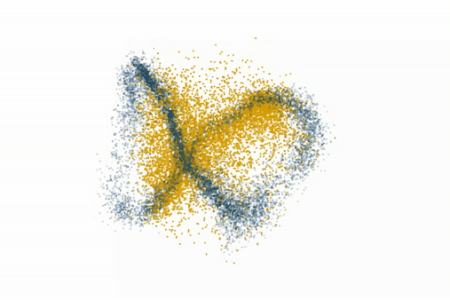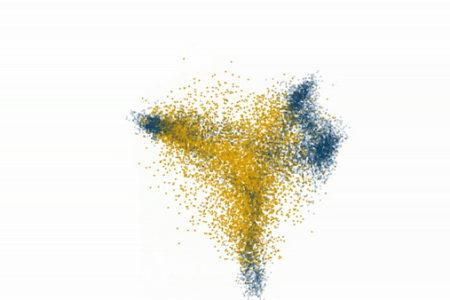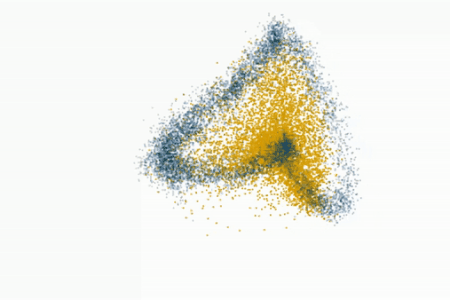
睡眠中、つまり回路が外部からの情報に晒されていない時でさえ、この回路はまるで過去の頭の向きの軌跡を夢見ているかのように、同じ一次元の円を力強く描き出す。

さらなる分析の結果、このリングは吸引器(アトラクター)として機能することが明らかになった。ニューロンが軌道から外れても、すぐに軌道に引き戻され、システムが迅速に修正される。このリングの吸引器特性により、抽象空間における頭部の方向表現は時間的に安定しており、これは周囲の世界に対する頭部の位置感覚を理解し、安定的に維持するために不可欠な条件である。

(脳内マップマッチング・・・)

「このリングがなければ、私たちはこの世で途方に暮れてしまうでしょう」とフィエテは説明する。

(コンパス・ニューロンとリングアトラクター多様体の関係をAIモードに整理して貰った)

(AIモード)

コンパスニューロンとリングアトラクター多様体(マニフォールド)は、動物の脳内における「頭部方向(方位)」の計算と維持を説明する、実体(生物学的基盤)と理論(数理モデル)の関係にあります。

具体的には、コンパスニューロンの集団活動が描く潜在的な状態空間の軌跡(多様体)が、まさに「1次元のリングアトラクター」を形成しています。

理論(リングアトラクター)

方位という「終わりと始まりがつながった連続的な変数(0〜360度)」を脳内で記憶・表現するため、数理システムとして「円環(リング)状に安定した固定点(アトラクター)が連なる多様体」が提唱されていました。

実体(コンパスニューロン)

ショウジョウバエなどの脳(中心複合体)に存在するコンパスニューロン(E-PGニューロンなど)は、物理的にもドーナツ状(楕円体)に配列しています。このニューロン集団の活動の「隆起(バンプ)」が現在の向きを表し、動物が回転するとバンプも円環上を移動します。

コンパスニューロンは数千〜個々の細胞レベルまでノイジーに活動していますが、それら全体の活動パターンを統計的に解析・可視化(トポロジカルデータ解析など)すると、高次元の空間から「きれいな1次元のリング状の形(多様体)」が浮かび上がります。これがリングアトラクター多様体です。

この多様体は「アトラクター(引き込みを伴う構造)」であるため、外部のノイズや一時的な脳の乱れによってニューロンの活動状態がリング(多様体)の軌道から外れそうになっても、回路内の相互作用(局所興奮と広域抑制)によって、瞬時に正しいリング上の軌道へと引き戻される性質を持っています。これにより、暗闇の中や睡眠中であっても、動物は自分の向きを頑健に維持することができます。

(コンパスニューロンを光遺伝学手法で処理して光に反応するようにして、光を当ててショウジョウバエの頭の向きを制御していたのか・・・

ひどいことをするなぁ・・・あれ?『脳の中の幽霊』に出てきた左耳に冷水を入れるのも同じことでは???)

(AIモード)

人間の脳卒中患者に対する左耳への冷水刺激(CVS: Caloric Vestibular Stimulation)による空間座標の再キャリブレーションと、ショウジョウバエの頭部方向(Heading)決定システムにおけるリングアトラクター・マニホールドへの摂動には、システム神経科学の観点から極めて深い本質的な共通点があります。

リングアトラクターモデルの本質は、一時的な速度入力などを時間的に足し合わせ(積分し)、その「位置」を持続的な活動として保持することにあります。

( IMUっぽい・・・)

• ハエの脳は、自分が動いた速度(角速度)の入力をリングアトラクターで積分して、現在の方向を保ちます。

• 人間の前庭システム(脳幹〜小脳〜大脳皮質)も、まさに「前庭眼球運動積分器(Vestibular Neural Integrator)」と呼ばれる仕組みを持っています。冷水刺激による持続的な流体力学的変化は、この積分器に定常的なエラー入力を与え続けるため、脳内の「方位マニホールド」のダイナミクスそのものを一時的に歪ませる(再キャリブレーションする)ことができます

両者ともに、「脳が予測している状態」と「入ってきた異常な感覚」の衝突を利用しています。

ハエのリングアトラクターは視覚情報(ランドマーク)と自己運動感覚(プロプリオセプション)を統合してバンプの位置を安定させていますが、片方のニューロンを直接摂動すると、ハエは「自分は動いていないはずなのに、世界(コンパス)が回った」という強烈な感覚(あるいは逆)を経験し、マニホールド内の安定点を再計算します。

人間のCVSも、「目で見ている静止した世界」と「前庭から来る激しい回転信号」の間に巨大な矛盾を発生させ、脳の多感覚マニホールドがその矛盾を解決しようと再キャリブレーションを試みた結果、副産物として左側の空間認識が一時的に開通するのです。

このように、「方位や空間という実体のないものを、脳という神経回路の中でどう表現し、どう修正するか」という基本設計(アーキテクチャ)は、ハエのリングアトラクターから人間の前庭皮質ネットワークにいたるまで、進化を超えて共通する数理的な原理(マニホールドのダイナミクス)に基づいている可能性が非常に高いです。
 

ハエ・ハッシュ

ハエ・ハッシュアルゴリズムのコネクトームテスト

(「ハエ・ハッシュ」という言葉につられただけ・・・

 Fly Hashingより日本語の方がゴロがいい)

(論文)

Dasgupta、Stevens、Navlakha (2017) は、ランダムなスパース射影と勝者総取りとしてモデル化されたショウジョウバエの嗅覚回路が、古典的な LSH を上回る局所性に敏感なハッシュであることを示した。

(AIモード)

Locality-Sensitive Hashing(LSH / 局所性鋭敏型ハッシュ)とは、「似ているデータ同士ほど、高い確率で同じハッシュ値(バケット)に集まる」ように設計されたハッシュ手法です。

通常のハッシュ関数(SHA-256など)は、データの改ざん検知や暗号化のために、わずか1ビットの違いであっても全く異なるハッシュ値を出力するように作られています。しかし、LSHはそれとは真逆の性質を持ち、データの類似性を保ったまま次元圧縮やグループ分けを行うために使われます。

(論文)

配線が不明であったため、射影はランダムであった。我々は、4 つの電子顕微鏡コネクトーム (MaleCNS、hemibrain、FlyWire、BANC、4 匹の動物、7 つの半球) に対してこれをテストした。

(コネクトームとは、個々のニューロンとシナプスの解像度で作成された配線図のこと)

(論文の結論)

このアルゴリズムの実数値 LSH に対する利点は、演算ごとではなく、アクティブユニットごとです。算術演算が安価な場合、密なガウス射影の方が検索性能が優れています。スパースまたはニューロモルフィックハードウェアの場合のように、アクティブユニットがボトルネックとなる場合、フライハッシュの方が優れた選択肢となる可能性がありますが、これはハードウェアの直接測定によって示される必要があります。

(???)

(AIモード)

「計算(算術演算)のコストが低い環境では従来のLSHが勝るが、ハードウェアの『アクティブなユニット(動作する素子やメモリ領域)の数』が最大のボトルネックになる環境(脳型ハードウェアなど)では、フライ・ハッシュが有利になる可能性がある」

(ハエの研究をよく目にする気がするけど何で?)

(AIモード)

ハエが「複雑な行動をとる脳」と「すべての神経細胞を特定できる小ささ」を完璧に両立した、神経科学に最適なモデル生物だからです。

• 線虫(約300個):小さすぎて高度な行動(記憶、学習、複雑な社会性など)のシミュレーションには物足りない。

• マウス(約1億個)/ ヒト(約860億個):現在の技術ではデータ量が膨大すぎて、個々のニューロンレベルで全脳を網羅するのはまだ不可能。

• ショウジョウバエ(約13万個):歩行、飛行、求愛、記憶、睡眠、意思決定などの高度な行動をするにもかかわらず、現在のテクノロジーで全脳をマッピングしきれる絶妙なサイズです。

2024年にはキイロショウジョウバエの成虫の全脳コネクトーム(約13万個のニューロン、約5,000万個のシナプス)が完全に解明され、大きなマイルストーンとなりました。

ハエのコネクトームは、米国のハワードヒューズ医学研究所(HHMI)のジャネリア・リサーチ・キャンパス(Janelia Research Campus)やプリンストン大学などの国際共同研究チーム(FlyWireなど)が主導しています。
彼らは解析した膨大なデータを世界中の研究者に無料・オープンソースで公開しています。

「特定の神経細胞(ニューロン)だけを狙って光らせる、または活動を止める」といった遺伝子操作(GAL4/UASシステムなど)が極めて容易です。

(Optogenetics (光遺伝学)か。光を使って生体内の細胞活動をミリ秒単位の超高精度でコントロールする技術。)

人工ニューラルネットワークにおける表現学習による創発的汎化

(で知った・・・)

ショウジョウバエの頭部の向きは、リングアトラクター・マニホールド内のニューロンを摂動させることで、光遺伝学的に操作することができる

( ①光を受けるとイオンを通す性質のあるタンパク質の遺伝子を使う

 ②安全なウイルスベクターなどを用いて、狙った特定の神経細胞にだけこの光感受性タンパク質を強制的に発現させる

 ③その細胞に特定の波長の光(レーザーやLEDなど)を照射すると、タンパク質が反応して細胞内にイオンが流れ込み、神経の電気信号をミリ秒単位でON(またはOFF)させることができる)

なぜ誤情報はより速く拡散するのか?

なぜ誤情報はより速く拡散するのか?

誤情報はエンゲージメントベースのプラットフォームでより速く拡散すると広く報告されている

例:『The spread of true and false news online』(2018)

  12万件以上のニュース拡散を分析し、「偽ニュースは真実よりも速く、深く、広く拡散する」ことを定量的に証明した。


(エンゲージメントベースのプラットフォーム?

ユーザーの「エンゲージメント(いいね、コメント、シェア、滞在時間などの反応や関与)」を最優先の指標として設計・運用されているデジタルプラットフォームやシステムのこと。SNSと読み替えることにして先に進む)

しかし、これまでの研究は主に経験的分析に焦点を当てており、この現象を引き起こす特定のアルゴリズムメカニズムを特定していませんでした。

2023年3月にXの推薦アルゴリズムがオープンソース化されたおかげで、本論文では、ソーシャルメディアプラットフォームが展開する推薦アルゴリズムのコンポーネントレベルの研究としては、我々の知る限り初めての研究を実施し・・・

我々の主な発見は、エンゲージメント代替可能性メカニズム、すなわち、推薦システムのスコア集約層におけるシグナルクラスの代替可能性であり、これにより、信頼性の低いコンテンツ1がエンゲージメントベースの推薦システムにおいて異なる形で伝播する。

(難しすぎる+長かったのでAIモードに要約してもらった・・・)

「Engagement Fungibility Mechanism(エンゲージメント代替可能性メカニズム)」とは、「システム(AI)の内部で、質の異なるさまざまなユーザー行動(いいね、リツイート、リプライなど)が、単一のスコアに合算されることで『お互いに代替可能(交換可能)』になってしまっている

おすすめスコア=(w1×いいねの数)+(w2×リツイートの数)+・・

w1 いいねの重み 例:0.5
w2 リツイートの重み
w3 リプライの重み 例:13.5
e4 引用リツイートの重み

    :

一見すると、「じっくり考えて書き込むリプライ(w3 = 13.5)」のほうが「ワンクリックのいいね(w1 = 0.5)」よりも圧倒的に高く評価されているため、質の高い投稿が有利に見えます。

• 「いいね」「リツイート」: ワンクリックでできる、反射的で手軽な行動(認知心理学でいう「システム1」の速い思考)。

• 「リプライ」「引用:」 文章を読み、自分で文字を入力して反論や同意を示す、熟考を伴う行動(「システム2」の遅い思考)。

しかし、計算式がただの「足し算(加重平均)」であるため、以下のような「価値の等価交換(代替)」が成立してしまいます。

真実のニュース: 100人がじっくり読み、10人が「なるほど」とリプライを送り、5人がリポストした。

フェイクニュース: 1万人がタイムラインでパッと見て、怒りや驚きで1,000人が「いいね」を押し、500人が脊髄反射でリポストした。

(画像処理の denoise っぽい。で、どうすると?)

1. リフレクティブ・スレッショルド・ゲート(熟考の関門)の導入

その投稿に対して、「文章を最後まで読んだ形跡があるか」「じっくり書かれたリプライが存在するか」など、ユーザーが熟考(Reflective)したというシグナルが一定数集まるまで、次の一斉拡散フェーズに進ませないゲート(関門)を設けます。

2. インタラクション摩擦(Friction)のコード組み込み

「この記事を読みましたか?共有する前に確認することをおすすめします」というポップアップを表示させます

(拡散したい人だけが先に進むようになる?)

3. 多層ニューラルネットワークによる「嘘の初動検知」

ディープラーニングモデルは、70〜99%の非常に高い精度でフェイクニュース特有の「過激な単語の組み合わせ」や「不自然な拡散スピード(初動の異常性)」を検知できます。

「フェイクの疑いあり」と判定した投稿は、どれだけ「いいね」を集めていても、おすすめスコアを強制的に一定割合カット(ダウングレード)し、おすすめ欄から隔離します

(ヒトには見えないノイズでAIの物体認識を誤認識させるようなことがSNSでも起きるんだろうなぁ)

4. プラットフォームへの「エンゲージメント税(重み付けの是正)」
経済学の研究者から提案されているアプローチで、アルゴリズムが「刺激的な投稿(ハイライトされたコンテンツ)」によって過剰なエンゲージメントを稼ぐ行為に対して、一種の「環境汚染税(ピグー税)」のような「エンゲージメント税(Engagement Tax)」の概念をアルゴリズムのインセンティブ設計に組み込みます。


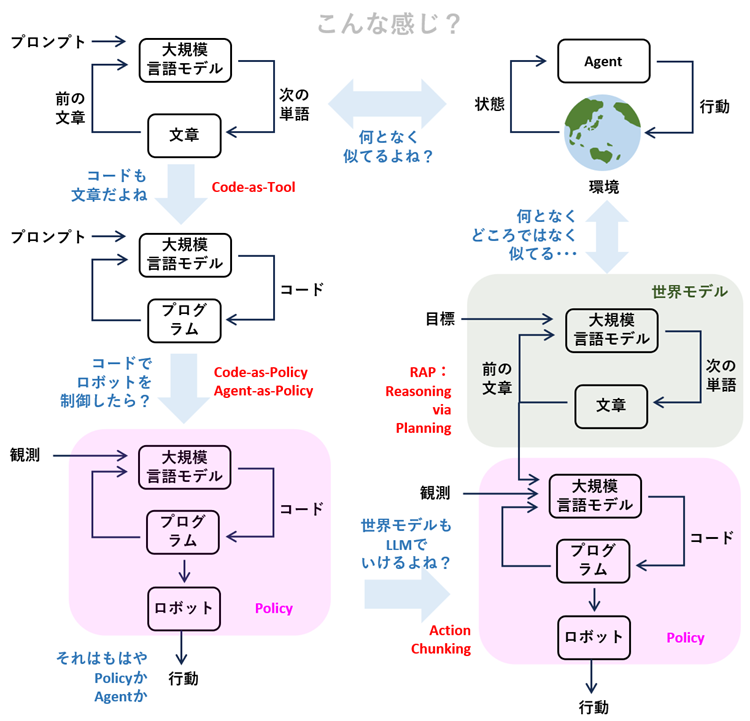
何にでも似ている言語モデル

AIモデルの規模が大きくなり過ぎて、自分では実装できないので中身を妄想してみた。

(全然違う可能性大)

・言語モデルは強化学習のエージェントと何となく似ている

・プログラムコードは言語の一種

・言語モデルでプログラムを作ろう

・プログラムを作れるなら、ロボットを制御しよう

・ロボットを制御すると出力は行動だ

・それはエージェント(ポリシー)そのもの

・世界モデルはエージェント(ポリシー)のシミュレーション

・世界モデルも言語モデルで作れるだろう

・何となくどころではなく似ている・・・という感じなのか???


妄想だけでは寂しいのでAIモードに聞いてみた (AIモードの妄想かもしれないけど)

Code-as-Policy
Code-as-Policy (CaP)は、「LLMが最初に一発でロボット制御コード(プログラム)を書き下し、ロボットがそれを実行する」というアプローチ。これには「途中で予期せぬ失敗(物を落とした、位置がズレたなど)が起きると、コードが途中で止まってしまいリカバリーできない」という弱点があった。

Agent-as-Policy
ロボットの行動を単なる固定された「プログラム(コード)」として扱うのではなく、AIエージェントそのものをロボットのリアルタイムな「ポリシー(制御方針)」として機能させるというアプローチをとる。

Action Chunking, RAP (Reasoning and Planning) との組み合わせ
GoogleのRT-2のように、VLMをそのまま方策として扱う「Agent-as-Policy」が主流になっているが、LLM/VLMは推論速度が遅く(数Hz〜数十Hz)、1ステップずつ文字や数値を生成していては、高速なロボット制御(通常100Hz以上が必要)に間に合わない。
そこで、Agent-as-Policy(基盤モデルを方策にする)の出力層に「Action Chunking」を組み込む。モデルを1回推論するだけで未来の行動シーケンスをまとめて出力できるようにすることで、推論の遅さをカバーし、滑らかで一貫性のあるロボット操作を実現している
(例)
・最上位レイヤー:RAP (Reasoning and Planning)
 高レベルの行動計画(ステップ)を頭の中で推論・分解する役割
・中間レイヤー:Agent-as-Policy
 ロボットの具体的な動きへと翻訳する「方策(Policy)」として機能
・最下位レイヤー:Action Chunking
 未来の数ステップ分の関節角度(軌道シーケンス)をまとめてガバッと出力する具現化の手法

(絵で説明してほしいところ・・・)

(言葉だと非効率なので内部はやっぱり潜在変数で・・・となるのかな)

183の謎

ど~でもいいことだけど、気づいたのでメモ。

・arXivの新着論文のリストのタイトルを日本語化してリンクに変換すると毎回[183]で失敗する。

・論文リストなんて自動生成だと思うけど、なんで[183]だけ失敗する?

・ダンプしてみたら、[183]の後にゼロ幅スペース(E2 80 8B)が2個付加されている

・付加しているのは Google翻訳 だった

・" [183] 半角スペース 半角文字 " のシーケンスを

 "[183] ゼロ幅スペース×2個 半角スペース 半角文字" に翻訳する

 [ ] 内の数字を200まで変えてみたけど、ゼロ幅スペースを付加するのは183だけだった

・訓練中に何か嫌なことでもあったんだろうか・・・(ど~でもいいけど・・・)

望ましくない側?

メタ認知による方向付け:科学的判断の構造を学ぶ

あるタスクを AI に学習させることの容易さは、そのタスクがどの程度検証可能かということに比例するが、科学的仮説はこの非対称性において「望ましくない側」に位置している。


(望ましくない側?)

(AIモード)

この一節は、「AIは『正解の判定が簡単なゲームや数学』なら超高速でマスターできるが、予測が正しいかどうかを確かめるために現実世界での泥臭い実験が必要となる『科学の未開拓分野(仮説の提示)』においては、その仕組み上、学習を効率よく進めるのが非常に難しい」という現代AIの構造的な限界(あるいは課題)を指摘しています。

(なるほど)

(論文に戻る)

科学者は単一の思考様式だけで推論を行うわけではありません。証拠が不十分なときは探索を行い、有効な枠組みがあるときは体系的に進め、結果の整合性が取れなくなったときは前提を疑います。彼らは、確実性が得られる前に、どの「微弱なシグナル」を追うべきかを判断します。こうした思考様式の切り替えは科学的発見の核心にある可能性がありますが、それらが生じる条件については、これまで十分に記録されてきませんでした。

(面白くなってきた・・・)

現在、テキストデータで学習された言語モデルは、科学の成果は継承していても、それを生み出したプロセスまでは継承していません。論文に記録されるのは最終的にたどった道筋であり、競合する仮説や方針転換、あるいは研究の過程で生じた疑念といった要素は記録されないからです。

(ふむふむ・・・)

その結果、主に公開されたテキストで学習したモデルは、答えが未知の段階で科学がどのように行われるかではなく、不確実性が解消された後に科学がどのように記述されるかを学習することになります。

(確かに・・・)

・・・

我々は、実際の長期にわたる研究プロセスにおいて記録された、科学者による「プロセスレベルの介入」に関する独自データセットから、これらの方向性を導き出しました。このデータセットの各事例は、科学的コンテキストを固定したまま認知スタンスのみを変化させた「反事実的(counterfactual)」な事例とペアになっています。

これらを組み合わせることで、新たな形態の制御が可能になります。本研究では「メタ認知的ステアリング(Metacognitive Steering)」を提案します。これは、モデル自身の「残差ストリーム(residual stream)」から現在の推論状態を推定し、探索・収束・精査といった処理の推移に応じて、その状態が求める方向へと制御を適用するクローズドループ・コントローラーです。

(ここらへんで脱落・・・)

(もう少しだけ、理解できそうなところを拾い読み)

科学的な失敗の記録は、構造化された機械可読形式で保存されることはほとんどありません。これは秘密主義の問題ではなく、単に科学者が形式化する理由がないために、実験ノートや記憶の曖昧な会話、放置された分析ノートなどに散在しているだけなのです。これはデータの問題です。こうした、そうでなければアクセスできない科学的知識を捉え、そこから学ぶために、私たちは科学的方法の特定の段階に合わせて設計された複数のモデルを備えたAI共同科学者を開発しました。このシステムは、文献検索、仮説生成、結果分析といった作業を加速させると同時に、出版された文献では捉えきれないもの、つまり進行中の科学的判断を捉えます。

・・・

科学は創造だけでなく、排除によっても進歩するからです。もっともらしいアイデアをいくつか生み出すことは有益です。そのうちの一つを真剣に調査し、それを却下すべきだと判断して、その理由を示す証拠を保存することこそが、科学的判断なのです。